摘要:最近用 MindSpeed 预训练一个 MoE 模型,碰到了两件怪事:续训后周期性 NaN,以及每次重启 loss 都往上跳一截。查到最后,是数据侧一行原地写把缓存的 mask 模板慢慢写坏了。
1. 事情的起因
最近在用 MindSpeed 预训练一个 MoE 模型,大概用了4台机器训练一个13B左右的参数,设置的是每 1000 步存一次Checkpoint
然后就遇到两件怪事:
- NaN:续训跑一段时间,反向传播里突然报
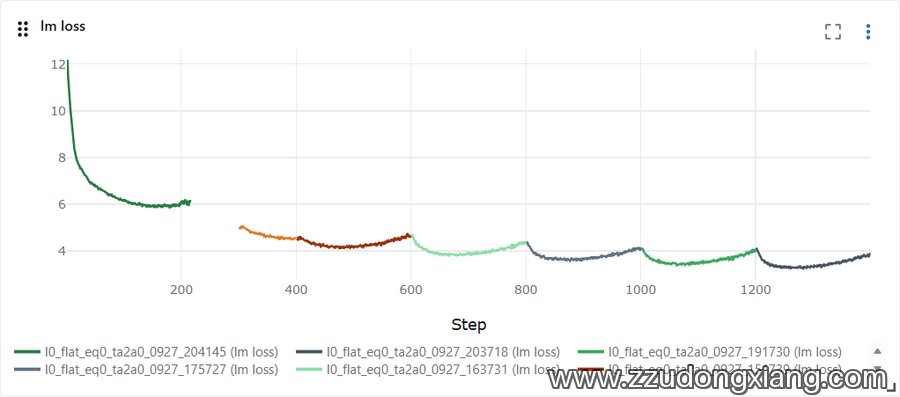
found NaN in local grad norm。奇怪的是loss还没爆炸,但是梯度先坏了,重启一下续训又好了。 - loss 跳升:每次重启之后的第一段日志,loss比重启前都要稍微高一点,0.35 到 0.45 之间。
单看哪一条都不像大事。跳升嘛,换个数据窗口很正常;NaN 嘛,偶发的数值意外。但这两件事都只在"重启"之后出现,就有点意思了。
2. 问题排查
一开始的怀疑清单很长:硬件、通信、精度、学习率、数据…逐个排查。
- 通信和硬件:小整数all_reduce之类的逐位校验跑了一遍,多种dtype、多种尺寸,还加了乱序压力,全过;训练期间的通信日志也很干净。
- 精度:bf16换FP32残差、改路由精度,问题依旧。
- 学习率:跨15倍幅度、换warmup形状,问题还是依旧。
- 数据内容:把挂掉那一步的原始文档离线解码出来看,就是普通文本,没毒;换个seed重建整条样本流,它还是死在进程启动之后的某个固定的位置。
排到后面就剩一条线索:死点跟"训练到第几步"关系不大,跟"这个进程启动之后吃了多少样本"关系很大。同一份配置重启一次,计数器清零,故障就得重新攒一遍才出现。
换句话说,问题不在训练动力学里,在"某个随进程增长的状态"里。范围一下小了很多。
3. 罪魁祸首
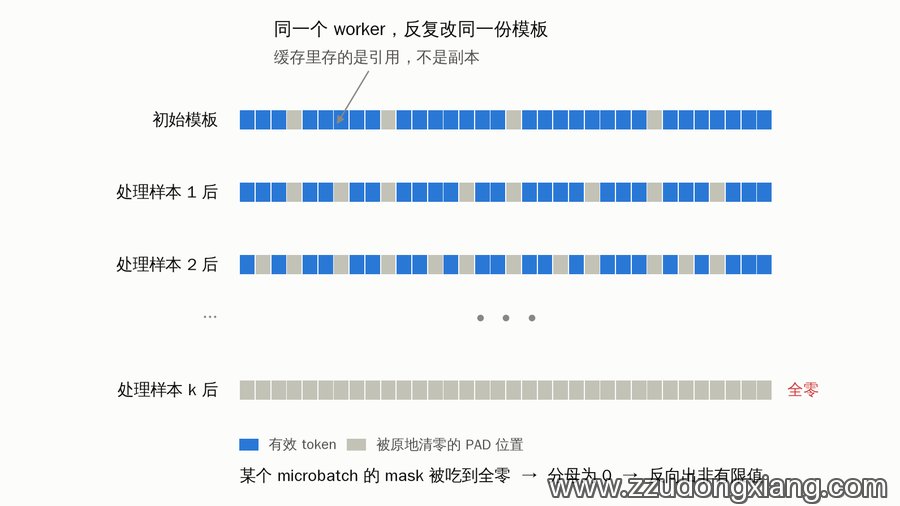
GPTDataset.__getitem__ 会缓存loss mask,但缓存的是引用。
# 屏蔽PAD,代码直接原地清零
loss_mask[labels == self._pad_token_id] = 0.0
于是每个DataLoader worker都在改同一份模板。偏偏这份数据的PAD和EOS用的是同一个token id(151643),packed之后样本里到处都是它,模板里的有效位置就这么被一点点吃掉。
造成的影响:
- 软污染:mask的有效token变少,训练loss的计算口径慢慢偏。污染期间loss偏低,重启重建模板之后就"跳升"——其实只是回到了正确值。
- 硬失败:当某个局部microbatch的mask被吃到全零,token分母为0,反向直接出非有限值。
而这份缓存是每个worker自己的,一重启就重建。所以故障严格按"进程内消费的样本数"复现,严丝合缝。
4. 实锤的证据
用原版代码、原数据和原helper,把DP32 × 2worker的64条数据流在CPU上重放了一遍:最早出现全零mask的是rank4/worker1,相对训练步1508,而历史崩溃日志里记的计数器是1507——对上了。加clone之后,那条样本的有效token是 4091、raw PAD是5,64条流逐样本和当前标签一致。
更直接的是冻结权重:同一份权重、同一批输入、同一份模型输出,只换mask,重算5120条序列的CE。
| 同一权重、同一模型输出 | CE 均值 |
|---|---|
| 重建历史污染mask | 1.902 |
| 当前样本的正确mask | 2.351 |
| 差值 | +0.449 nats |
当然,这只能量化mask的测量效应,不能反推历史每一步的权重到底偏了多少。
5. 一行修复
loss_mask = loss_mask.clone()
loss_mask[labels == self._pad_token_id] = 0.0
位置要在任何一次对当前样本PAD的原地写之前,包括第一次建立缓存的那条路径。
绕了一圈,结论其实很朴素:这不是数值问题,也不是硬件问题,是数据管道里的一行原地写。
这类 bug 最坑的地方是它不报错、不抛异常,也不在出问题的那一步留下线索——只在某个说不准的步数上把进程杀掉,而且换 LR、换精度、换机器都一模一样,很容易被误判成偶发的数值不稳定。